本期检索说明
先读取 content/collections/deep-radar 全部历史原文链接,并按 URL、标题与实现机制去重。本期检索窗口为 2026-10-26 至 2026-11-01,最终收录 Linux、Kotlin/Native、Java/JVM 各 1 篇一手材料;三篇均同时具备实测数据、源码或汇编级证据、原理解释与可迁移的工程方法,且未在往期出现。
Rust 本周有一项“无需构造 MIR 即识别 trivial const”的 rustc 草案,虽然给出了 perf.rlo 数据,但仍标为 rough draft,二级指标存在回退且语义讨论未收敛,因此只放在文末延伸阅读。Zig 本周没有找到同时满足三项证据红线的新材料,不为凑数收录。三篇正文均是开放补丁或 PR,文中会把“已测结果”与“当前分支尚待验证”分开。
| 主题 | 原始发布日期 | 一手来源与交叉验证 | 截稿状态 | 推荐强度 |
|---|---|---|---|---|
| io_uring 单 NAPI busy-poll 预算修复 | 2026-10-28 04:48(中原标准时间) | io_uring 邮件原帖 / LKML 镜像 / 2 文件源码 diff / bpftrace 计数 | v2 开放评审;动态注册路径未单独测试 | 强烈推荐,典型的“调度让步不等于预算结束” |
| Kotlin/Native in-process object emission | 2026-10-30 21:41(中原标准时间) | Kotlin PR #9434 / KT-90368 / LLVM C API 源码 diff / 大型工程 benchmark | 实验性开放 PR,需显式开关 | 强烈推荐,编译流水线 I/O 与进程边界优化范本 |
| RISC-V ZGC constant-null store | 2026-10-30(中原标准时间) | OpenJDK PR #33644 / JBS / Webrev / C2 AD 规则 / JMH 与 IR test | 开放评审;当前基线只完成生成与编译检查 | 推荐,重点看测试边界与控制组 |
01 · io_uring:need_resched() 只应让出 CPU,不应偷走剩余忙轮询预算
原文与日期: Pavel Begunkov,2026-10-28 04:48(中原标准时间);io_uring 邮件原帖 与 LKML/Openwall 镜像及完整 diff。
为什么值得读: 这是一个很小却很有迁移价值的状态机错误。io_uring 只注册一个 NAPI 时,把结束回调直接交给 napi_busy_loop_rcu();内核看到 need_resched() 后退出内层循环,io_uring 却把这次“调度让步”误判成 10ms 忙轮询预算已经耗尽,随后进入睡眠。多 NAPI 路径有外层循环重新进入,反而不受同一问题影响。
核心技术结论: v2 在 io_wait_queue 中保存绝对截止时间 napi_busy_poll_end。内层 NAPI loop 因 need_resched() 返回后,io_uring 只要发现截止时间未到,就再次进入忙轮询;真正超预算、收到事件或等待条件改变时才结束。补丁保留 held-NAPI 快路与静态注册语义,没有把 need_resched() 屏蔽掉,因此仍允许调度器取得控制权。
/* 关键不是延长 timeout,而是把“本次 inner loop 结束”
 * 与“整个 io_uring busy-poll 预算结束”分开。 */
while (!io_napi_busy_loop_should_end(iowq, start_time))
    napi_busy_loop_rcu(napi_id, loop_end, iowq, true, budget);
最有价值的实验、源码与 benchmark 细节: 测试基于 io_uring-7.4、x86-64、HZ=1000、PREEMPT_DYNAMIC lazy、未做 CPU isolation,r8169 仅 1 个 RX queue,busy-poll 预算 10ms。一个固定在 CPU 上的 SCHED_FIFO waker 每 1ms 唤醒一次:单 NAPI 在修复前每个 10ms 周期只忙轮询约 0.5–1.5ms,约 0.8M polls/s;修复后可用满约 10ms,约 16.2M polls/s,循环计数约 20.25 倍。无 waker 控制组为 15.3M → 16.2M;双 NAPI 控制组 7.2M → 7.1M,说明修复瞄准的是单 NAPI 的提前退出,而非泛化地提高轮询频率。作者用 bpftrace 同时跟踪 __io_napi_busy_loop() 进出、napi:napi_poll 和结束回调返回值。注意这些是 loop-rate 与 budget-consumption 数据,不等于应用吞吐;动态 NAPI 注册走同一路径但未单独实测,后续 cond_resched() 调整也明确留待另一补丁。
适合的工程师背景: 熟悉 io_uring、NAPI、busy polling、Linux 调度抢占点,或在网络 I/O 中维护“时间预算 + 可抢占内层循环”的工程师。
预计阅读收益: 约 35–50 分钟;能学会把局部循环退出原因与全局预算状态解耦,并用单 NAPI、双 NAPI、空闲和定时唤醒四组对照定位行为差异。
02 · Kotlin/Native:让 LLVM 在进程内直接发射目标文件
原文与日期: JetBrains Kotlin 团队,2026-10-30 21:41(中原标准时间);Kotlin PR #9434、KT-90368 benchmark 与设计记录 及 33 个文件的源码 diff。
为什么值得读: Kotlin/Native 的 per-file incremental cache 在一个拥有数千源文件的工程中,会把 N 个 LLVM module 逐个序列化成 bitcode,再为每个文件启动一次外部 clang 生成 object;不仅写盘与读盘重复,clang 初始化也无法复用。补丁引入实验性 -Xin-process-obj-emission,直接把活的 LLVMModuleRef 交给 LLVM C API,是真正沿数据生命周期删除边界成本,而不是微调编译参数。
核心技术结论: LlvmBitcodeCompiler.kt 调用 LLVMTargetMachineEmitToFile(..., LLVMObjectFile, ...) 发射 object,并在错误路径释放 LLVM message;ObjectFiles phase 的输入从 bitcode/object 路径改为 LLVMModuleRef + BitcodeCompiler + Path。因为 object emission 可能修改 module,原本在外部 clang 前后的 IR dump/verify 也必须提前。目标机初始化包含 AsmPrinter/AsmParser;GlobalISel 目前只在 Darwin 启用,因为 Linux x86-64 观察到巨大内存峰值,其他平台退回 SelectionDAG;Windows/Linux 保持 function/data sections,Windows/Android 保留 emulated TLS 配置。
val error = LLVMTargetMachineEmitToFile(
    targetMachine, llvmModule, outputPath, LLVMObjectFile, errorMessage.ptr
)
if (error != 0) {
    val message = errorMessage.value?.toKString()
    LLVMDisposeMessage(errorMessage.value)
    error(message ?: "LLVM object emission failed")
}
最有价值的实验、源码与 benchmark 细节: 在大型 animeko 工程上,总构建时间 287.0s → 220.0s(-23.4%,1.30×);link task 224.8s → 167.5s(-25.5%,1.34×);各 cache build 合计 213.3s → 157.4s(-26.2%,1.36×)。最直接对应设计的 ObjectFiles phase 从 77.0s 降到 34.3s,减少 55%,约 2.24×;最终 link 仅 8.3s → 7.2s,说明收益主要来自消除 per-file bitcode 往返与进程启动,而不是链接器突然变快。32/64 位与平台差异通过目标机配置显式保留,但 PR 仍为实验性,尤其 Linux x86-64 的 GlobalISel 内存峰值说明“把工具搬进进程”也会改变峰值 RSS 与故障隔离边界。
适合的工程师背景: 熟悉 Kotlin/Native、KLIB/增量缓存、LLVM C API,或维护编译器中间产物、外部工具链进程与缓存流水线的工程师。
预计阅读收益: 约 50–70 分钟;能掌握如何用 phase 级数据判断磁盘与进程边界是否值得移除,以及怎样在原位 object emission 下重新安置 verify、dump、目标机与错误处理。
03 · RISC-V ZGC:为常量 null 存储跳过无意义的地址合成
原文与日期: OpenJDK RISC-V/ZGC 贡献者,2026-10-30(中原标准时间);OpenJDK PR #33644、JDK-8396162 与 Webrev 00。
为什么值得读: ZGC 的普通指针存储必须把地址编码成带颜色的 zpointer。对常量 null,通用 RISC-V 路径仍先把零物化到寄存器、按 ZPointerLoadShift 左移,再 OR 上可重定位的 store-good color;前两步没有信息量。补丁通过 C2 matcher 的专用规则消除它们,同时保留 pre-barrier、慢路径、relocation 与内存序,适合学习“局部删指令,不能删语义边界”的优化方法。
核心技术结论: 新增 zStorePNull 与 zStorePVolatileNull,直接匹配 StoreP mem immP_0。z_color 与 store_barrier_fast 接受 noreg 作为新地址:空引用路径直接把 relocatable good color 装入目标寄存器,不再执行 shift/OR;非空引用继续走原路径。volatile 与普通规则分开,避免把内存序差异藏在同一个模板里。
通用路径:  materialize 0 → slli ZPointerLoadShift → or store_good_color
专用路径:  load relocatable store_good_color
最有价值的实验、源码与 benchmark 细节: jtreg 新增 7 类方法:普通字段、volatile、release、数组、volatile 数组、先存非空再存空、分配后存空;IR 断言要求 NULL_STORE=1,并禁止零地址物化节点,执行阶段还穿插 System.gc()。较早基线 de15ba… 上完成 RISC-V fastdebug 交叉构建、8 组功能/GC stress 与 IR 验证;QEMU + Zalasr 下 7 个方法、9 条 IR 规则全部通过,未修改 JVM 会按预期在优化断言上失败。固定到 SpacemiT K3 X100 的 6 组配对 JMH 中,普通 null 字段存储耗时下降 13.58%(配对 95% CI 12.66–14.49%),null 数组元素下降 7.45%(CI 6.96–7.93%);volatile 与非 null 控制组没有一致变化。数字来自热数据、无分配微基准,不能外推应用吞吐。更重要的是,当前 PR 基线 6cf31a… 只确认 fastdebug/release 的 ADLC 生成与编译通过,完整运行验证仍待补齐;因此正文不把早期基线的测试包装成当前提交已全部通过。
适合的工程师背景: 熟悉 HotSpot C2 AD 文件、ZGC colored pointers、RISC-V 汇编与 IR framework,或正在为 JIT 增加常量特化存储规则的工程师。
预计阅读收益: 约 45–65 分钟;能看到 matcher、barrier assembler、relocation 与 jtreg IR 断言怎样共同证明一个两三条指令级优化,并学会把当前基线与历史 benchmark 的证据强度分开。
中国大陆 ToC 硬件价格观察
数据口径
窗口为 2026-10-03 至 2026-11-01,单位人民币,六类硬件固定同一 SKU,只连接真实日期点。今天复核到 CPU、HDD 与 SSD 三个当前规格报价;GPU 与 DRAM 页面明确显示“暂无报价”,不把旧价复制到今天。主板页面顶部的 ¥1,169 实为 B850M-E 等其他规格,已从固定 B850M-PLUS 序列剔除;本期只采用 10 月 30 日可核验的同 SKU ¥1,349。
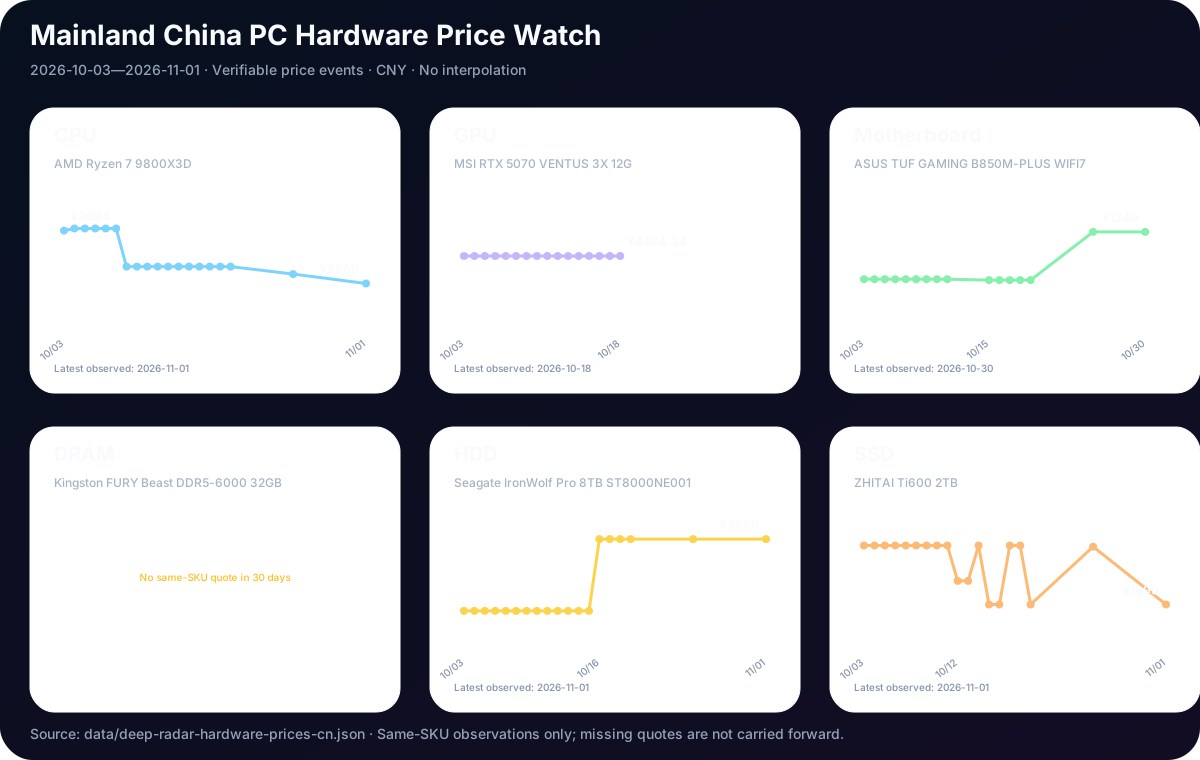
| 类别 | 最新可复核价 | 30 日窗口内真实走势 | 建议 |
|---|---|---|---|
| CPU | Ryzen 7 9800X3D,京东 ¥2,569 | ¥2,699 → ¥2,569,较 10/25 再降 ¥22.10,刷新窗口低点 | 入手;已在 30 日低点,有明确装机需求可买,仍需核对券与店铺 |
| GPU | 今日暂无报价;最后可复核 10/18 ¥4,464.34 | 10/3–18 的可见样本相同,之后断价 | 观望;缺失报价不能解释成横盘,更不能据此预测继续下跌 |
| 主板 | B850M-PLUS,10/30 ¥1,349 | 10/3–11 为 ¥1,299,10/15–19 为 ¥1,298,随后升至 ¥1,349 | 观望;较近期可比价高约 3.9%,且页面混列其他规格,先核对完整型号 |
| DRAM | 暂无报价;最后可复核 9/9 ¥3,900 | 30 日窗口没有同 SKU 可比点 | 观望;不以 64GB、DDR4、C36 或其他容量替代固定 32GB C30 套条 |
| HDD | IronWolf Pro 8TB ST8000NE001,京东 ¥3,550 | 10/3–15 为 ¥1,849,10/16 起可见渠道切换为 ¥3,550并持平 | 观望;跳变更像低价渠道退出,当前价接近窗口高位 |
| SSD | ZHITAI Ti600 2TB,京东 ¥1,699 | 窗口 ¥1,699–1,799;较 10/25 回落 ¥98,回到窗口低点 | 入手;固定 2TB 规格已回到 30 日低位,但不把促销回落外推为持续下跌 |
价格来源: 9800X3D、MSI RTX 5070 VENTUS 3X、ASUS TUF B850M-PLUS WIFI7、Kingston FURY DDR5-6000 32GB、IronWolf Pro 8TB、ZHITAI Ti600 2TB。
判断依据
本期购买建议只依赖固定 SKU 的公开可见报价与 30 日样本,不加入无法由一手来源核实的新品、停产或原厂减产传闻。CPU 与 SSD 都回到窗口低点,给出“入手”而不是“继续下跌预期”;主板较近期同规格价格反弹,HDD 又发生渠道切换,均不足以支持追价。GPU 与 DRAM 缺少当前同 SKU 价格,数据质量优先于勉强给趋势。
其它你可能关心的
- Rust:不构造 MIR 即识别 trivial const 的 rough-draft 实验
- OpenJDK:String.equals 小常量长度的专用比较
- OpenJDK:RISC-V
movptr地址物化优化
本期结论
三篇材料都在修复同一种工程性浪费:局部退出被误当作全局结束、活 LLVM module 被迫跨磁盘和进程往返、已知为零的地址仍走完整着色合成。真正可迁移的方法不是“删一步”,而是先找出必须保持的边界:调度公平性、IR 验证与目标机配置、GC barrier 与内存序;再用对照组、产物验证和基线声明证明优化没有越界。